XCrawl怎么用:给OpenClaw配AI爬虫数据源

XCrawl怎么用?这篇讲清它和OpenClaw爬虫怎么配合:对话框里发一句话装技能包,官网拿免费API密钥激活,两步就能让AI直接拿到结构化数据。原文列的四个痛点都在——反爬拦截、JS渲染页面、结果杂乱、数据喂不进大模型;XCrawl对应给了动态住宅IP、浏览器指纹、JSON和Markdown直出、原生MCP支持,单页抓取、全站爬取、搜索SERP都能做。文末把原文没交代的几件事挑了出来:1000次额度用完之后怎么算、绕过反爬的边界在哪。想给AI爬虫配个数据源,照着这篇看。
先把它是什么说清楚:给 AI 装一只手
原文标题是「XCrawl × OpenClaw」,通篇看下来是很典型的产品推介:一边是 OpenClaw(原文管它叫「龙虾」),一边是 XCrawl 这个爬虫数据接口,重点是这两者怎么接起来。
OpenClaw 这类 AI 客户端,你让它分析一个网页,它得先把网页内容拿到手。拿不到,后面全是空的。XCrawl 干的就是这一步:你给网址,它把内容抠出来,直接给你 JSON 或者 Markdown。
所以这俩不是竞争关系,是上下游。原文那句「最佳拍档」听着像自夸,但逻辑上成立——AI 会分析,爬虫会取数,缺一环都不成。
原文列的四个卡点,都是真卡点
它开篇问了四个问题,我照原文的顺序列一遍,因为这四条基本覆盖了抓数据的全部麻烦:
爬虫任务频繁被反爬机制拦截
复杂 JS 渲染页面,数据提取不出来
抓回来一堆杂东西,清洗要花大量时间
拿不到结构化数据,喂不进大模型
这四条里,第二条和第三条是绝大多数人真正会撞上的。现在大量页面是前端渲染的,你直接请求 HTML,拿回来的是一个空壳框架,正文一个字没有。而就算抓到了,标签套标签,还得自己写规则清洗。
第四条最隐蔽:数据明明抓到了,格式是散的,模型读起来效率极低,你还得再整理一遍。
能力清单:四条,两条最实在
| 原文标题 | 原文怎么说 | 我的判断 |
|---|---|---|
| 智能数据提取 | 自动识别并提取表格、列表、文章内容,直接输出 JSON / Markdown | 最实用的一条。这类活儿最费时间的就是清洗 |
| 反爬壁垒突破 | 内置全球动态住宅 IP 池和智能浏览器指纹,能绕过 Cloudflare、reCAPTCHA | 能力描述清楚,但边界问题下面单独说 |
| LLM 友好输出 | 原生支持 MCP 协议,数据可直接喂给 Claude 等 AI 助手 | 决定它能不能被 AI 直接调用,是接 OpenClaw 的前提 |
| 多场景支持 | 单页 Scrape、全站 Crawl、搜索引擎 SERP 数据 | 三种粒度,覆盖了大部分用法 |
四条里最关键的词其实是 MCP。没有它,XCrawl 只是个普通接口,你还得自己写代码去调;有了它,AI 客户端能把它当工具直接调,原文说的「对话式安装」才立得住。
原文还写了两句「99%+ 数据提取成功率」和「效率提升 300%」。这两个数我原样留着,但得说清楚:原文没给测试条件,没给样本量,也没说拿什么当基准。自家宣传数字,看个方向就行,别当承诺。
两步接入,原文写得算具体
接入流程它给了两步,也确实不长:
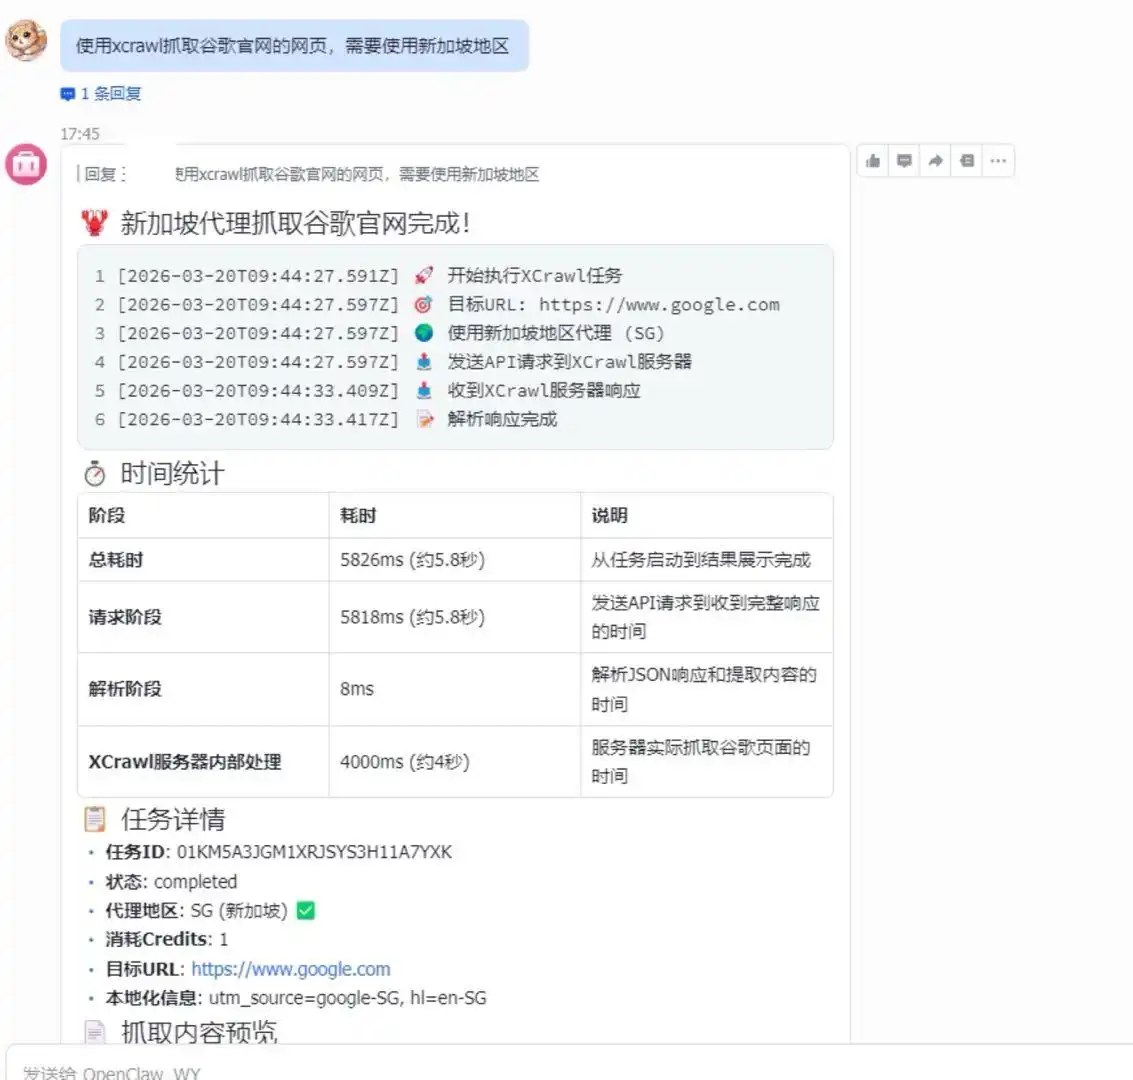
装技能包:在对话框里发一句话就行——
帮我安装xcrawl skills,等它装完。激活功能:去官网 xcrawl.com 拿一个免费 API 密钥,原文说含 1000 次调用额度,拿到之后填进对话框,功能就激活了。
帮我安装xcrawl skills
这两步都不是敲命令,是说话。这一点跟传统接口差别很大——传统接口你得先读文档、装 SDK、配环境变量,再写个脚本试跑。这里是把「装一个能用的工具」的门槛压到了「说一句话」。
那 1000 次额度够干什么?按一天抓 30 个页面算,能用一个多月。个人开发者调试、跑个小项目,绰绰有余;真要全站爬,这点额度一上午就烧完。
四个场景,挑跟你相关的
原文给了四个典型场景,我按自己的经验给它排个序:
竞品监控:实时跟踪竞品网站数据
LLM 训练:批量抓取高质量文本,用于大模型微调
内容聚合:自动采集多平台内容,生成 AI-ready 的结构化数据
市场分析:获取搜索引擎实时数据
四个里我最认第三个。做内容的人都知道,素材散在十几个平台上,人工整理一遍就是半天。要是能把「抓取 + 结构化」合成一步,省下的是纯体力活。
「竞品监控」和「市场分析」都得看频率。一天跑一次还行,跑成分钟级,额度先烧完,人家站点也可能直接把你封了。
「LLM 训练」这条要慎重。批量抓来的文本,版权和授权是另一码事,能抓到不等于能用。
原文没交代的三件事
一、1000 次之后怎么算钱
原文只说「按调用量付费更划算」,具体单价、阶梯、有没有包年,一个字没提。这直接决定它是「先拿免费额度试」还是「试完就得掏钱」,接之前先去官网看价格页。
二、绕过反爬的边界在哪儿
原文把「绕过 Cloudflare、reCAPTCHA」当卖点写。这里得说句公道话:技术能做,不代表可以随便做。
抓自己的站点、抓明确授权的合作方站点、抓公开数据集,这些都没问题。抓别人的站、还绕开对方的验证,多数站点的服务条款是不允许的,踩过界的案例不少。
能抓不等于该抓,能绕过不等于允许绕过。工具是中性的,用之前先想清楚这个站我有没有权利抓。
三、除了 MCP,还有没有普通接口
原文没提 REST 调用方式和鉴权细节。如果你的场景不在 AI 客户端里、要自己写程序批量跑,就得先确认它是否也提供标准 HTTP 接口——这一步原文是空的。
写在最后(我的看法)
「AI 客户端 + 数据接口」这种组合,现在冒出来很多,套路都差不多:一边负责理解,一边负责取数,中间用 MCP 连起来。XCrawl 这套没什么特别新的东西,胜在步骤短、门槛低。
但我更在意的是它暴露出来的一个变化:装一个数据能力的成本,已经降到「说一句话」。这活儿几年前只有程序员干得了。
给三个建议。第一,先用免费额度把「抓一个页面 → 出 JSON」跑通,看结果干不干净,这比看宣传页管用。第二,别拿它去抓你要脸面的站,尤其是带登录、带付费墙的;聚合类用法抓来的东西还得改写,不然就是搬运。第三,真要靠它做业务,先去官网把价格和限额问明白,别等额度烧光了才发现比人工还贵。
原文那种「让 OpenClaw 拥有超能力」的说法,我一个做内容的听着有点悬。工具的价值从来不在让你多抓多少,而在省下多少原本要人干的时间。这一点想明白了,就不会被「300%」这种数字牵着走。